
В данном материале будут рассмотрены такие объекты базы данных Microsoft SQL Server как индексы, Вы узнаете, что такое индексы, какие типы индексов бывают, как их создавать, оптимизировать и удалять.
Что такое индексы в базе данных?
Индекс — это объект базы данных, который представляет собой структуру данных, состоящую из ключей, построенных на основе одного или нескольких столбцов таблицы или представления, и указателей, которые сопоставляются с местом хранения заданных данных. Индексы предназначены для более быстрого получения строк из таблицы, другими словами, индексы обеспечивают быстрый поиск данных в таблице, что значительно повышает производительность запросов и приложений. Индексы также могут быть использованы и для обеспечения уникальности строк таблицы, гарантируя тем самым целостность данных.
Типы индексов в Microsoft SQL Server
В Microsoft SQL Server существуют следующие типы индексов:
- Кластеризованный (Clustered) – это индекс, который хранит данные таблицы в отсортированном, по значению ключа индекса, виде. У таблицы может быть только один кластеризованный индекс, так как данные могут быть отсортированы только в одном порядке. По возможности каждая таблица должна иметь кластеризованный индекс, если у таблицы нет кластеризованного индекса, такая таблица называется «кучей». Кластеризованный индекс создается автоматически при создании ограничений PRIMARY KEY (первичный ключ) и UNIQUE, если до этого кластеризованный индекс для таблицы еще не был определен. В случае создания кластеризованного индекса для таблицы (кучи), в которой есть некластеризованные индексы, то после создания все их необходимо перестроить.
- Некластеризованный (Nonclustered) – это индекс, который содержит значение ключа и указатель на строку данных, содержащую значение этого ключа. У таблицы может быть несколько некластеризованных индексов. Создаваться некластеризованные индексы могут как на таблицах с кластеризованным индексом, так и без него. Именно этот тип индекса используется для повышения производительности часто используемых запросов, так как некластеризованные индексы обеспечивают быстрый поиск и доступ к данным по значениям ключа;
- Фильтруемый (Filtered) – это оптимизированный некластеризованный индекс, который использует предикат фильтра для индексирования части строк в таблице. Если хорошо спроектировать такой тип индекса, то он может повысить производительность запросов, а также снизить затраты на обслуживание и хранение индексов по сравнению с полнотабличными индексами;
- Уникальный (Unique) – это индекс, который обеспечивает отсутствие повторяющихся (одинаковых) значений ключа индекса, гарантируя тем самым уникальность строк по данному ключу. Уникальными могут быть как кластеризованные, так и некластеризованные индексы. Если создавать уникальный индекс по нескольким столбцам, индекс гарантирует уникальность каждой комбинации значений в ключе. При создании ограничений PRIMARY KEY или UNIQUE SQL сервер автоматически создает уникальный индекс для ключевых столбцов. Уникальный индекс может быть создан только в том случае, если у таблицы на текущий момент отсутствуют дублирующие значения по ключевым столбцам;
- Колоночный (Columnstore) – это индекс, основанный на технологии хранения данных в виде столбцов. Данный тип индекса эффективно использовать для больших хранилищ данных, поскольку он может увеличить производительность запросов к хранилищу до 10 раз и также до 10 раз уменьшить размер данных, так как данные в Columnstore индексе сжимаются. Существуют как кластеризованные колоночные индексы, так и некластеризованные;
- Полнотекстовый (Full-text) – это специальный тип индекса, который обеспечивает эффективную поддержку сложных операций поиска слов в символьных строковых данных. Процесс создания и обслуживания полнотекстового индекса называется «заполнением». Существует такие типы заполнения как: полное заполнение и заполнение на основе отслеживания изменений. По умолчанию SQL сервер полностью заполняет новый полнотекстовый индекс сразу после его создания, но на это может потребоваться значительный объем ресурсов, в зависимости от размеров таблицы, поэтому есть возможность откладывать полное заполнение. Заполнение на основе отслеживания изменений используется для обслуживания полнотекстового индекса после его первоначального полного заполнения;
- Пространственный (Spatial) – это индекс, который обеспечивает возможность более эффективного использования конкретных операций на пространственных объектах в столбцах с типом данных geometry или geography. Данный тип индекса может быть создан только для пространственного столбца, также таблица, для которой определяется пространственный индекс, должна содержать первичный ключ (PRIMARY KEY);
- XML – это еще один специальный тип индекса, который предназначен для столбцов с типом данных XML. Благодаря XML-индексу повышается эффективность обработки запросов к XML столбцам. Существует два вида XML-индекса: первичные и вторичные. Первичный XML-индекс индексирует все теги, значения и пути, хранимые в XML столбце. Он может быть создан, только если у таблицы есть кластеризованный индекс по первичному ключу. Вторичный XML-индекс может быть создан, только если у таблицы есть первичный XML-индекс и используется он для повышения производительности запросов по определенному типу обращения к XML-столбцу, в связи с этим существует несколько типов вторичных индексов: PATH, VALUE и PROPERTY;
- Также существуют специальные индексы для таблиц, оптимизированных для памяти (In-Memory OLTP) такие как: Хэш (Hash) индексы и некластеризованные индексы, оптимизированные для памяти, которые создаются для сканирования диапазона и упорядоченного сканирования.
Создание и удаление индексов в Microsoft SQL Server
Перед тем как приступать к созданию индекса его необходимо хорошо спроектировать, для того чтобы эффективно использовать этот индекс, так как плохо спроектированные индексы могут не увеличить производительность, а наоборот снизить ее. Например, большое количество индексов в таблице снижает производительность инструкций INSERT, UPDATE, DELETE и MERGE, потому что при изменении данных в таблице все индексы должны быть изменены соответствующим образом. Общие рекомендации по проектированию индексов мы с Вами рассмотрим в отдельном материале, а сейчас давайте переходить непосредственно к рассмотрению процесса создания и удаления индексов.
Примечание! В качестве SQL сервера у меня выступает версия Microsoft SQL Server 2016 Express.
Создание индексов
Для создания индексов в Microsoft SQL Server существует два способа: первый – это с помощью графического интерфейса среды SQL Server Management Studio (SSMS), и второй – это с помощью языка Transact-SQL, мы с Вами разберем оба способа.
Исходные данные для примеров
Давайте представим, что у нас есть таблица с товарами под названием TestTable, в которой есть три столбца:
- Product >Пример создания кластеризованного индекса
Как я уже говорил, кластеризованный индекс создается автоматически, если мы, например, при создании таблицы указываем конкретный столбец в качестве первичного ключа (PRIMARY KEY), но так как мы этого не сделали, давайте рассмотрим пример самостоятельного создания кластеризованного индекса.
Для создания кластеризованного индекса мы можем у таблицы указать первичный ключ, и тем самым кластеризованный индекс будет создан автоматически или мы можем создать кластеризованный индекс отдельно.
Для примера давайте просто создадим кластеризованный индекс, без создания первичного ключа. Сначала сделаем это с помощью Management Studio.
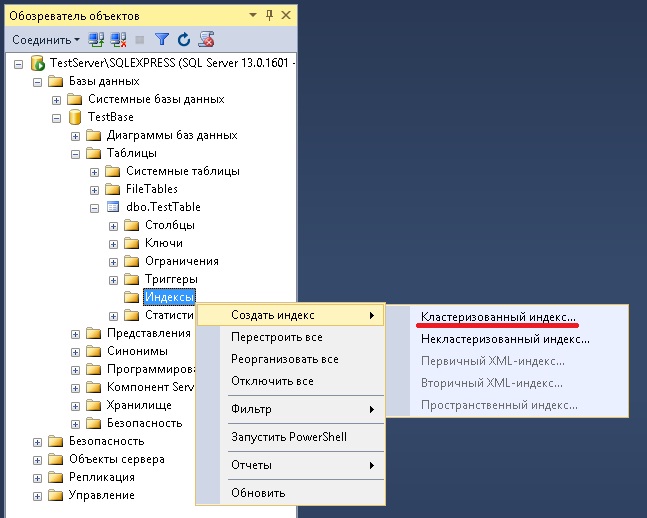
Открываем SSMS и в обозревателе объектов находим нужную таблицу и щелкаем правой кнопкой мыши по пункту «Индексы», выбираем «Создать индекс» и тип индекса, в нашем случае «Кластеризованный».
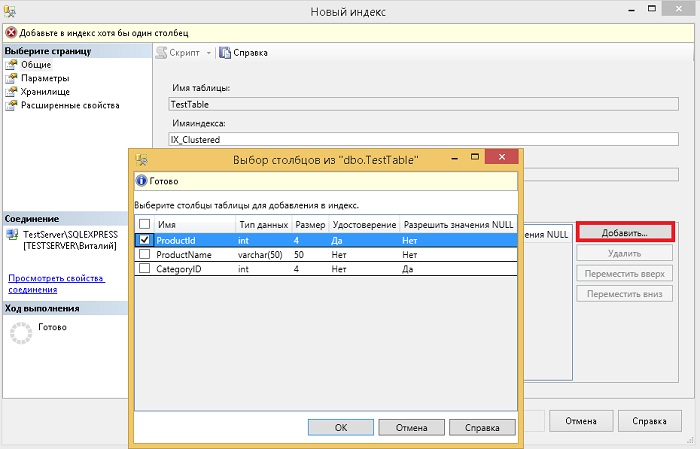
Откроется форма «Новый индекс», где нам необходимо указать имя нового индекса (оно должно быть уникальным в пределах таблицы), также указываем, будет ли этот индекс уникальным, если мы говорим об идентификаторе товара в таблице товаров, то, конечно же, он должен быть уникальным. Потом выбираем столбец (ключ индекса), на основе которого у нас будет создан кластеризованный индекс, т.е. будут отсортированы строки данных в таблице, с помощью кнопки «Добавить».
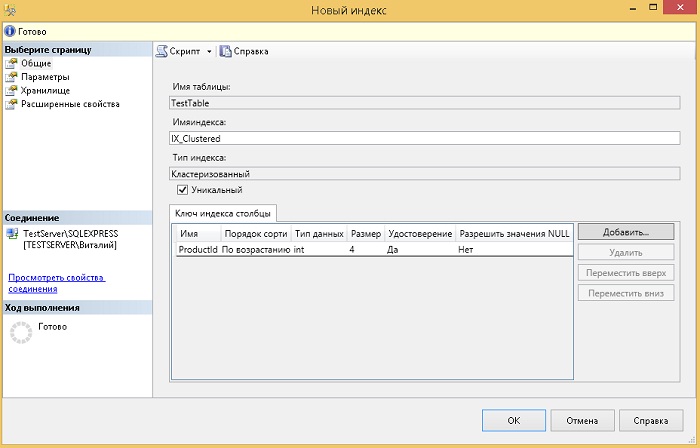
После ввода всех необходимых параметров жмем «ОК», в итоге будет создан кластеризованный индекс.
Точно также можно было бы создать кластеризованный индекс, используя инструкцию T-SQL CREATRE INDEX, например, вот так
Или, как мы уже говорили, можно было бы использовать и инструкцию создания первичного ключа, например
Пример создания некластеризованного индекса с включенными столбцами
Сейчас давайте рассмотрим пример создания некластеризованного индекса, при этом мы укажем столбцы, которые не будет являться ключевыми, но будут включаться в индекс. Это полезно в тех случаях, когда Вы создаете индекс для конкретного запроса, например, для того чтобы индекс полностью покрывал запрос, т.е. содержал все столбцы (это называется «Покрытием запроса»). Благодаря покрытию запроса повышается производительность, так как оптимизатор запросов может найти все значения столбцов в индексе, при этом не обращаясь к данным таблиц, что приводит к меньшему числу дисковых операций ввода-вывода. Но помните, что включение в индекс неключевых столбцов влечет за собой увеличение размера индекса, т.е. для хранения индекса потребуется больше места на диске, а также может повлечь и снижение производительности операций INSERT, UPDATE, DELETE и MERGE на базовой таблице.
Для того чтобы создать некластеризованный индекс с помощью графического интерфейса Management Studio, мы также находим нужную таблицу и пункт индексы, только в данном случае мы выбираем «Создать -> Некластеризованный индекс».
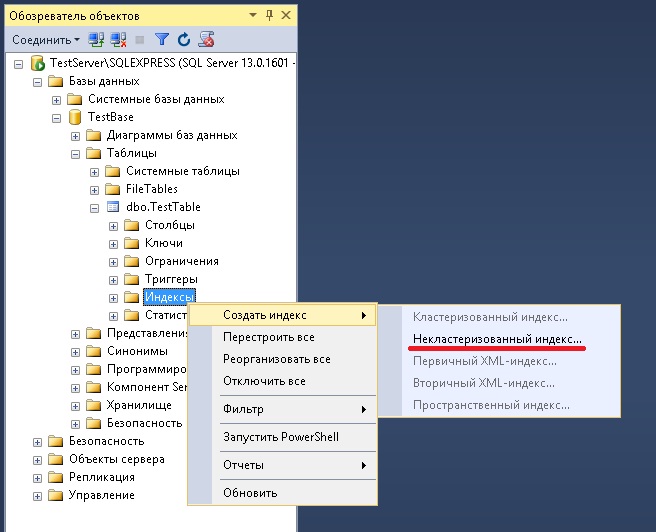
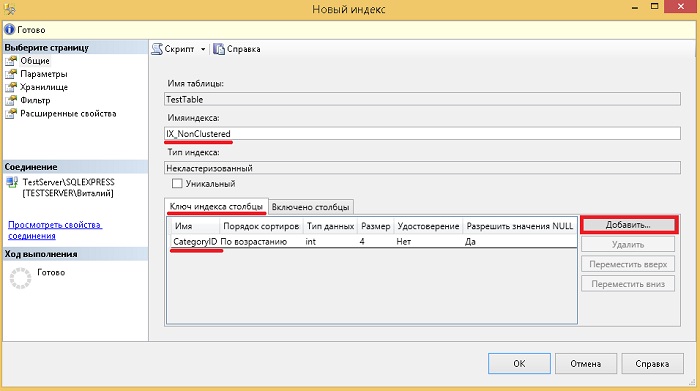
После открытия формы «Новый индекс» мы указываем название индекса, добавляем ключевой столбец или столбцы с помощью кнопки «Добавить», например, для нашего тестового случая давайте укажем CategoryID.
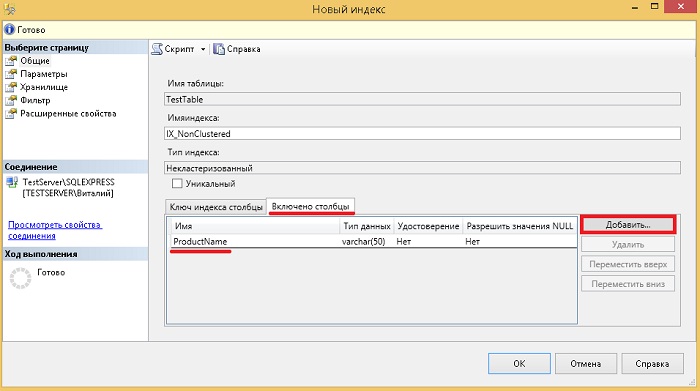
Далее переходим на вкладку «Включено столбцы» и с помощью кнопки «Добавить» добавляем столбцы, которые мы хотим включить в индекс, в нашем случае, например, ProductName.
На Transact-SQL это будет выглядеть следующим образом.
Пример удаления индекса в Microsoft SQL Server
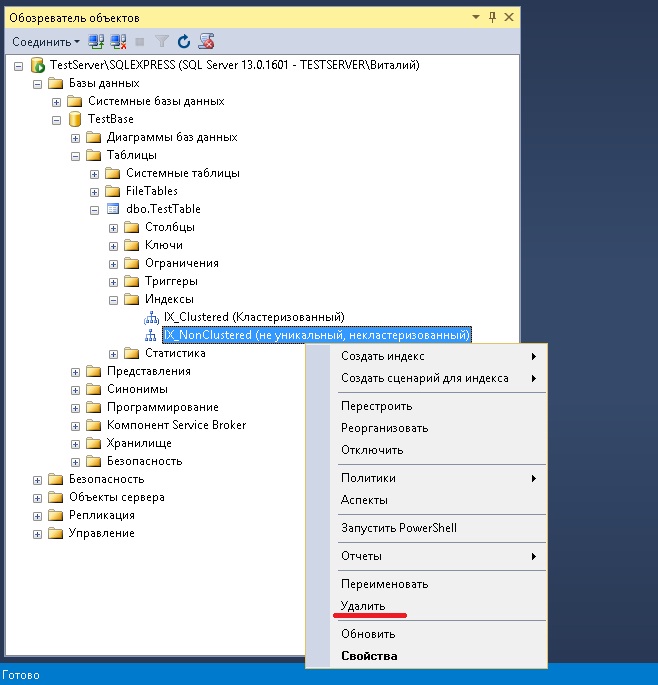
Для того чтобы удалить индекс можно щелкнуть правой кнопкой по нужному индексу и нажать «Удалить», затем подтвердить свое действия нажав «ОК».
или также можно использовать инструкцию DROP INDEX, например
Следует отметить, что инструкция DROP INDEX неприменима к индексам, которые были созданы путем создания ограничений PRIMARY KEY и UNIQUE. В данном случае для удаления индекса нужно использовать инструкцию ALTER TABLE с предложением DROP CONSTRAINT.
Оптимизация индексов в Microsoft SQL Server
В результате выполнения операций обновления, добавления или удаления данных в таблицах SQL сервер автоматически вносит соответствующие изменения в индексы, но со временем все эти изменения могут вызвать фрагментацию данных в индексе, т.е. они окажутся разбросанными по базе данных. Фрагментация индексов влечет за собой снижение производительности запросов, поэтому периодически необходимо выполнять операции обслуживания индексов, а именно дефрагментацию, к таким можно отнести операции реорганизации и перестроения индексов.
В каких случаях использовать реорганизацию индекса, а в каких перестроение?
Чтобы ответить на этот вопрос сначала необходимо определить степень фрагментации индекса, так как в зависимости от фрагментации индекса тот или иной метод дефрагментации будет предпочтительней и эффективней. Для определения степени фрагментации индекса можно использовать системную табличную функцию sys.dm_db_index_physical_stats, которая возвращает подробные сведения о размере и фрагментации индексов. Например, используя следующий запрос, Вы можете узнать степень фрагментации индексов у всех таблиц в текущей базе данных.
В данном случае нас интересует столбец avg_fragmentation_in_percent, т.е. процентная доля логической фрагментации.
Так вот, Microsoft рекомендует:
- Если степень фрагментации менее 5%, то реорганизацию или перестроение индекса вообще не стоит запускать;
- Если степень фрагментации от 5 до 30%, то имеет смысл запустить реорганизацию индекса, так как данная операция использует минимальные системные ресурсы и не требует долговременных блокировок;
- Если степень фрагментации более 30%, то необходимо выполнять перестроение индекса, так как данная операция, при значительной фрагментации, дает больший эффект чем операция реорганизации индекса.
Лично я могу добавить следующее, если у Вас небольшая компания и база данных не требует максимальной отдачи в режиме 24 часа в сутки, т.е. она не суперактивная БД, то Вы можете смело периодически выполнять операцию перестроения индексов, при этом даже не определяя степень фрагментации.
Реорганизация индексов
Реорганизация индекса – это процесс дефрагментации индекса, который дефрагментирует конечный уровень кластеризованных и некластеризованных индексов по таблицам и представлениям, физически переупорядочивая страницы концевого уровня в соответствии с логическим порядком (слева направо) конечных узлов.
Для реорганизации индекса можно использовать как графический инструмент SSMS, так и инструкцию Transact-SQL.
Реорганизация индекса с помощью Management Studio
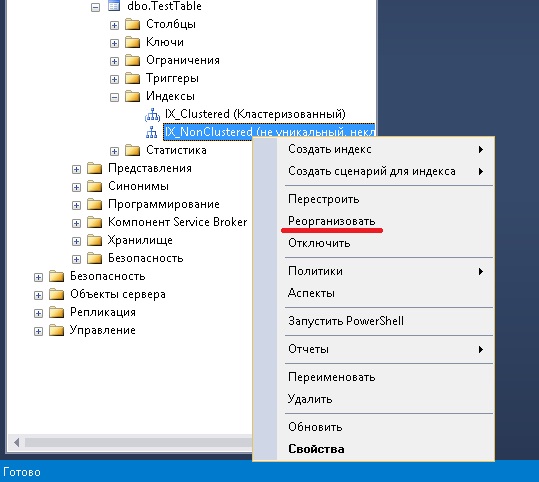
Реорганизация индекса с помощью Transact-SQL
Перестроение индексов
Перестроение индекса – это процесс, при котором происходит удаление старого индекса и создание нового, в результате чего фрагментация устраняется.
Для перестроения индексов можно использовать два способа.
Первый. Используя инструкцию ALTER INDEX с предложением REBUILD. Эта инструкция заменяет инструкцию DBCC DBREINDEX. Обычно для массового перестроения индексов используется именно этот способ.
И второй, используя инструкцию CREATE INDEX с предложением DROP_EXISTING. Можно использовать, например, для перестроения индекса с изменением его определения, т.е. добавления или удаления ключевых столбцов.
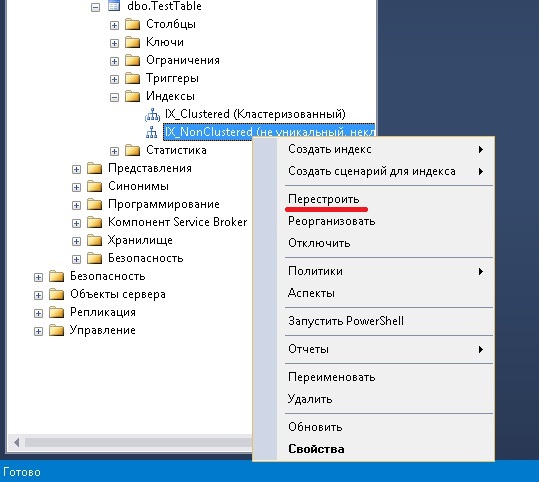
В Management Studio функционал для перестроения также доступен. Правой кнопкой по нужному индексу «Перестроить».
На этом материал по основам индексов в Microsoft SQL Server закончен, если Вас интересует язык T-SQL, то рекомендую почитать мою книгу «Путь программиста T-SQL», удачи!
ОБЛАСТЬ ПРИМЕНЕНИЯ:  SQL Server База данных SQL Azure
 Azure Synapse Analytics (хранилище данных SQL) Parallel Data Warehouse APPLIES TO: SQL Server Azure SQL Database Azure Synapse Analytics (SQL DW) Parallel Data Warehouse
Индекс является структурой на диске, которая связана с таблицей или представлением и ускоряет получение строк из таблицы или представления. An index is an on-disk structure associated with a table or view that speeds retrieval of rows from the table or view. Индекс содержит ключи, построенные из одного или нескольких столбцов в таблице или представлении. An index contains keys built from one or more columns in the table or view. Эти ключи хранятся в виде структуры сбалансированного дерева, которая поддерживает быстрый поиск строк по их ключевым значениям в SQL Server SQL Server . These keys are stored in a structure (B-tree) that enables SQL Server SQL Server to find the row or rows associated with the key values quickly and efficiently.
Таблица или представление может иметь индексы следующих типов. A table or view can contain the following types of indexes:
- Кластеризованные индексы сортируют и хранят строки данных в таблицах или представлениях на основе их ключевых значений. Clustered indexes sort and store the data rows in the table or view based on their key values. Этими значениями являются столбцы, включенные в определение индекса. These are the columns included in the index definition. Существует только один кластеризованный индекс для каждой таблицы, так как строки данных могут храниться в единственном порядке. There can be only one clustered index per table, because the data rows themselves can be stored in only one order.
- Строки данных в таблице хранятся в порядке сортировки только в том случае, если таблица содержит кластеризованный индекс. The only time the data rows in a table are stored in sorted order is when the table contains a clustered index. Если у таблицы есть кластеризованный индекс, то таблица называется кластеризованной. When a table has a clustered index, the table is called a clustered table. Если у таблицы нет кластеризованного индекса, то строки данных хранятся в неупорядоченной структуре, которая называется кучей. If a table has no clustered index, its data rows are stored in an unordered structure called a heap.
Некластеризованные индексы имеют структуру, отдельную от строк данных. Nonclustered indexes have a structure separate from the data rows. В некластеризованном индексе содержатся значения ключа некластеризованного индекса, и каждая запись значения ключа содержит указатель на строку данных, содержащую значение ключа. A nonclustered index contains the nonclustered index key values and each key value entry has a pointer to the data row that contains the key value.
Указатель из строки индекса в некластеризованном индексе, который указывает на строку данных, называется указателем строки. The pointer from an index row in a nonclustered index to a data row is called a row locator. Структура указателя строки зависит от того, хранятся ли страницы данных в куче или в кластеризованной таблице. The structure of the row locator depends on whether the data pages are stored in a heap or a clustered table. Для кучи указатель строки является указателем на строку. For a heap, a row locator is a pointer to the row. Для кластеризованной таблицы указатель строки данных является ключом кластеризованного индекса. For a clustered table, the row locator is the clustered index key.
Вы можете добавить неключевые столбцы на конечный уровень некластеризованного индекса, чтобы обойти существующее ограничение на ключи индексов и выполнять полностью индексированные запросы. You can add nonkey columns to the leaf level of the nonclustered index to by-pass existing index key limits, and execute fully covered, indexed, queries. Дополнительные сведения см. в статье Create Indexes with Included Columns. For more information, see Create Indexes with Included Columns. Дополнительные сведения об ограничениях на ключи индексов см. в разделе Спецификации максимально допустимых параметров SQL Server. For details about index key limits see Maximum Capacity Specifications for SQL Server.
Как кластеризованные, так и некластеризованные индексы могут быть уникальными. Both clustered and nonclustered indexes can be unique. Это означает, что никакие две строки не имеют одинаковое значение для ключа индекса. This means no two rows can have the same value for the index key. В противном случае индекс не является уникальным, и несколько строк могут содержать одно и то же значение. Otherwise, the index is not unique and multiple rows can share the same key value. Дополнительные сведения см. в статье Создание уникальных индексов. For more information, see Create Unique Indexes.
Обслуживание индексов таблиц и представлений происходит автоматически при любом изменении данных в таблице. Indexes are automatically maintained for a table or view whenever the table data is modified.
Дополнительные типы специальных индексов см. в разделе Indexes . See Indexes for additional types of special purpose indexes.
Индексы и ограничения Indexes and Constraints
Индексы создаются автоматически при определении ограничений PRIMARY KEY или UNIQUE на основе столбцов таблицы. Indexes are automatically created when PRIMARY KEY and UNIQUE constraints are defined on table columns. Например, при создании таблицы с ограничением UNIQUE Компонент Database Engine Database Engine автоматически создает некластеризованный индекс. For example, when you create a table with a UNIQUE constraint, Компонент Database Engine Database Engine automatically creates a nonclustered index. При настройке PRIMARY KEY Компонент Database Engine Database Engine автоматически создает кластеризованный индекс, если он еще не существует. If you configure a PRIMARY KEY, Компонент Database Engine Database Engine automatically creates a clustered index, unless a clustered index already exists. Если вы пытаетесь применить ограничение PRIMARY KEY в существующей таблице, для которой уже создан кластеризованный индекс, SQL Server применяет первичный ключ с помощью некластеризованного индекса. When you try to enforce a PRIMARY KEY constraint on an existing table and a clustered index already exists on that table, SQL Server enforces the primary key using a nonclustered index.
Как оптимизатор запросов использует индексы How Indexes are used by the Query Optimizer
Правильно построенные индексы могут сократить количество дисковых операций ввода-вывода, уменьшить потребление системных ресурсов, таким образом улучшая производительность запроса. Well-designed indexes can reduce disk I/O operations and consume fewer system resources therefore improving query performance. Индексы могут быть полезны во множестве запросов, содержащих инструкции SELECT, UPDATE, DELETE или MERGE. Indexes can be helpful for a variety of queries that contain SELECT, UPDATE, DELETE, or MERGE statements. Рассмотрим запрос SELECT Title, HireDate FROM HumanResources.Employee WHERE Employee > в базе данных AdventureWorks2012 AdventureWorks2012 . Consider the query SELECT Title, HireDate FROM HumanResources.Employee WHERE Employee > in the AdventureWorks2012 AdventureWorks2012 database. При выполнении этого запроса оптимизатор запросов оценивает все доступные методы получения данных и выбирает наиболее эффективный метод. When this query is executed, the query optimizer evaluates each available method for retrieving the data and selects the most efficient method. Этим методом может являться просмотр таблицы или просмотр одного или более индексов, если они существуют. The method may be a table scan, or may be scanning one or more indexes if they exist.
При выполнении просмотра таблицы оптимизатор запросов считывает все строки таблицы и извлекает строки, удовлетворяющие критериям запроса. When performing a table scan, the query optimizer reads all the rows in the table, and extracts the rows that meet the criteria of the query. Просмотр таблицы формирует много дисковых операций ввода-вывода и может быть ресурсоемкой операцией. A table scan generates many disk I/O operations and can be resource intensive. Но если результирующий набор запроса содержит высокий процент строк таблицы, то просмотр таблицы может оказаться самым эффективным методом. However, a table scan could be the most efficient method if, for example, the result set of the query is a high percentage of rows from the table.
Когда оптимизатор запросов использует индекс, он выполняет поиск по ключевым столбцам индекса, находит место хранения запрашиваемых строк и извлекает оттуда совпадающие строки. When the query optimizer uses an index, it searches the index key columns, finds the storage location of the rows needed by the query and extracts the matching rows from that location. В основном поиск по индексу протекает намного быстрее, чем поиск по таблице, так как в отличие от таблицы индекс часто содержит мало столбцов в каждой строке и строки расположены в отсортированном порядке. Generally, searching the index is much faster than searching the table because unlike a table, an index frequently contains very few columns per row and the rows are in sorted order.
Оптимизатор запросов обычно выбирает наиболее эффективный метод при выполнении запросов. The query optimizer typically selects the most efficient method when executing queries. Но если отсутствуют доступные индексы, оптимизатор запросов должен использовать просмотр таблицы. However, if no indexes are available, the query optimizer must use a table scan. Ваша задача — спроектировать и создать индексы, которые лучше всего подходят для конкретной среды, чтобы оптимизатор запросов мог выбирать из нескольких эффективных индексов. Your task is to design and create indexes that are best suited to your environment so that the query optimizer has a selection of efficient indexes from which to select. SQL Server SQL Server включает помощник по настройке ядра СУБД , который может помочь при анализе среды базы данных и при выборе соответствующих индексов. provides the Database Engine Tuning Advisor to help with the analysis of your database environment and in the selection of appropriate indexes.
Дополнительные сведения о правилах и принципах проектирования индексов см. в статье Руководство по проектированию индексов SQL Server. For more information about index design guidelines and internals, refer to the SQL Server Index Design Guide.
Кучи, кластеризованные индексы и некластеризованные индексы
Рассмотрим теорию индексов.
• SQL Server хранит данные на страницах размером 8 килобайт – 8,060 байт
• Страницы принадлежащие объекту(например таблице) связаны в двунаправленный список
• Первые 8 страниц «объекта» хранятся в смешанных участках. После этого данные хранятся только в унифицированных участках.
• 8 страниц группируются в «участки». Смешаные участки хранят данные из разных «объектов». Унифицированные участки хранят данные одного «объекта»
• SQL Server использует страницы именуемыми — «карты размещения индексов» (Index Allocation Map) или кратко — IAM для определения страниц принадлежащих «объекту»
Кучи – это данные, хранящиеся без какой-либо определенной сортировки, не имеющие индексов, доступ и поиск по таким данным происходит последовательно при сканировании страниц, и может занимать довольно долгое время влияя негативно на производительность.
Кучи подходят для хранения небольшого количества данных.
Существуют два типа индексов: кластеризованные и некластеризованные.
Кластеризованный индекс хранит в своих узлах-листьях реальные строки данных.
Некластеризованный индекс является вспомогательной структурой, которая указывает данные в таблице
Кластеризованные индексы
- В SQL Server индексы организованы в виде сбалансированных деревьев. Каждая страница в сбалансированном дереве индекса называется узлом индекса.
Верхний узел сбалансированного дерева называется корневым. Узлы нижнего уровня индекса называются конечными. Все уровни индекса между корневыми и конечными узлами называются промежуточными. В кластеризованном индексе конечные узлы содержат страницы данных базовой таблицы. На страницах индекса корневого и промежуточного узлов находятся строки индекса. Каждая строка индекса содержит ключевое значение и указатель либо на страницу промежуточного уровня сбалансированного дерева, либо на строку данных на конечном уровне индекса. Страницы на каждом уровне связаны в двунаправленный список.На схеме — кластеризованный индекс выглядит в виде B-дерева, где хранятся реальные строки данных таблицы в отсортированном порядке в узлах-листьях.
Т.Е. данные будут храниться так:
Т.к. данные кластеризованного индекса хранятся в узлах-листьях, они станут доступны, когда будет найден определенный узел-лист, это даст сокращение количества операций ввода-вывода и повысит производительность системы.
Также данные при чтении приходят отсортированными по индексу. К примеру, если известно, что всегда будет требоваться сортировка данных в определенном порядке, то использование кластеризованного индекса означает, что вам не потребуется выполнять сортировку данных при выборке.
Недостатком является то, что доступ к таблице всегда происходит через индекс, что приводит к дополнительной нагрузке на SQL Server. Доступ к данным начинается с корневого узла и проходит через индекс, пока не будет достигнут узел-лист, содержащий нужные данные. При больших объемах данных создается много узлов-листьев, соответственно количество уровней индекса, необходимых для поддержки столь большого числа узлов-листьев — увеличивается, и приводит к увеличению количества операций ввода-вывода для перемещения от корневого узла к узлу-листу.
Т.к. кластеризованный индекс хранит реальные данные, нельзя создать более одного кластеризованного индекса в таблице.
Некластеризованные индексы
Некластеризованный индекс не содержит реальных данных таблицы в узлах-листьях. Узлы-листья содержат один из двух типов информации о местоположении строк данных.
Если в таблице не создан кластеризованный индекс, то некластеризованные индексы по этой таблице хранят в своих узлах-листьях идентификаторы строк (Row ID на первой схеме). Идентификатор строки указывает на реальную строку данных в таблице, по сути это — значение, включающее в себя номер файла данных, номер страницы и местоположение строки на этой странице.
Если в таблице создан кластеризованный индекс, то некластеризованные индексы содержат в узле-листе значение ключа кластеризованного индекса для этих данных (вторая схема). При достижении узла-листа некластеризованного индекса находящееся в нем значение кластеризованного ключа используется для поиска в кластеризованном индексе, соответствующий узел-лист которого содержит искомую строку данных.
Возможно создать до 249 некластеризованных индексов на одну таблицу.


